教學 › 球衣模組:安裝與製作入門
球衣模組:安裝與製作入門
首頁一直寫著「換球衣」,但球衣到底是哪幾個檔、住在哪裡、檔名為什麼長那樣,
站上從來沒有一頁講清楚。這頁把它量出來,
包括一個量之前沒想到的結果:
球衣佔 models.big 的 82.6%,
是這個檔裡最大的一塊,也是球員臉皮的五倍多。
先說清楚這頁的數字是從哪一份遊戲量的
本頁的項目數、檔案數、覆蓋率,量的是一台裝過台灣模組的遊戲。 剛安裝好的原版數字小很多 —— 例如臉皮 504 對 894、大頭照 1,487 對 6,638、 語音號碼 1,673 對 4,343。
格式與結構的部分兩邊一樣,那是遊戲程式決定的; 會變的是「有幾個」。完整對照見 原版與這台機器差在哪。
難度
★★☆ 要動封裝檔
時間
讀完約 10 分鐘
這頁給你的
檔名規則 + 一支唯讀腳本
可以還原嗎
可以,動到哪個先備份哪個
先講署名:這頁裡的球衣不是 toni 做的
這頁拿來當範例的,是 2009 年那份台灣模組包。裡面的東西各有作者, 下面幾條全部照當年說明檔的原文寫,本站沒有加自己的判斷:
- 中華隊 2X 球衣:當年一位模組作者 tony7494550 製作的經典賽中華隊球衣。
- 中華隊 1X 球衣:小雪靈從上面那份 2X 轉成 1X。
- 台灣之光隊與日本夢幻隊的隊徽、LOC 語系檔、 大都會新球場的名稱更新:都是小雪靈做的。
- 台灣之光模組本身:出自小豪前輩。
上面列的是當年文件裡留下的圈內代號,本站不連結任何個人身分、不公開聯絡方式、 不轉載任何一個檔案,說明檔裡的網址也一律不列。
🛟 動手之前:先完整備份整個遊戲資料夾
把整個遊戲資料夾複製一份到別的地方, 包括裡面存放紀錄的資料夾。不要挑檔案,整包複製最省事也最保險。
「紀錄」是指這些(它們跟遊戲檔混在同一個資料夾裡):
Support\MVP Baseball 2005\—— 遊戲自己建的, 裡面是設定(MVPOptions_Options.sav)與手把設定 (controller.cfg)。剛安裝好時沒有這個資料夾,玩過才出現。- 王朝、老闆模式、名單與玩家檔案的存檔(
*_Franchise.sav、*_Owner Mode.sav、*_Rosters.sav、*_Profile.sav)—— 沒有固定的資料夾名,你或你裝的模組包叫它什麼它就叫什麼。找不到就用這一行找:
dir /s /b "〔你的遊戲資料夾〕\*.sav"find "〔你的遊戲資料夾〕" -name "*.sav"上面第一行 Windows、第二行 Mac。 本站每一支工具都會自己備份它要動的那一個檔, 但那只保得住那一個檔 —— 整包備份保的是「你玩到現在的一切」。 完整做法看備份與還原 SOP。
⚡ 只想趕快做完?照這四步
- 要真的把球衣寫進封裝檔的話,這一課只講規則、不帶你動手,直接去把一套球衣裝進遊戲那一課,那裡有腳本會自動分類、先清點再安裝、寫完逐位元組複驗,一行還原。
- 只想知道自己這台有哪些球衣檔,把本頁「自己在自己的遊戲上看一遍」那段程式存成
list_uniform.py。它全程唯讀,不會碰到你的遊戲檔,需要 Python 3。 - 跑它,第一個參數是遊戲資料夾,第二個是球隊編號(就是
team.dat欄位 6 的美術編號減 1,不確定就從 0 開始試)
python list_uniform.py "你的遊戲資料夾" 5 - 照印出來的清單數:一支球隊是五種檔散在三個封裝檔裡,
u###x.fsh、f###x.fsh、###.fsh、###x.fsh、l###.fsh,改一隊時這幾種要一起換,別漏掉。
印出 0 個怎麼辦、字母為什麼會跳號、1X 跟 2X 差在哪,往下讀;只想複習跳到📌 重點整理。
先看一件事:球衣是 models.big 裡最大的一塊
把 models.big 的 4,211 個項目全部列出來、照檔名分類加總,得到的結果跟直覺差很多。
大家都知道那個檔裝著球員的臉,可是臉只佔一成五:
data\models.big 的目錄整份讀出來,
依檔名開頭分成四類加總。大小取目錄登記的長度(壓縮後),不是解開後的大小。
百分比是各類佔那 4,211 個項目總和的比例。
那 4,211 筆加起來是 561,817,990 bytes,
再加上檔頭與目錄的 73,322 bytes,剛好等於整個檔的
561,891,312 bytes(535.9 MB)。
models.big 是 data 底下最大的單一檔案,
第二大的是 frontend\portrait.big,265,883,417 bytes。
臉皮那 2,682 個項目是 894 張臉,每張各三個檔(.fsh、.ord、.orl)。所以「換球衣」跟「換臉」不是同一個等級的工作
換臉那課只要改一個純文字檔就好。
換球衣一定要動 models.big,
464,156,581 bytes 的球衣資料全在那裡面。
球衣檔不能直接丟進資料夾,一定得寫進封裝檔;本站手上這份 2009 模組的說明檔,
也是要使用者用一支安裝程式把壓縮檔裝進去。
五個檔家族:命名對照表
一套球衣不是一個檔,是散在三個封裝檔裡的五種檔案。 下表每一欄的數量都是把那三個封裝檔的目錄列出來數的:
| 檔名樣式 | 住在哪個封裝檔 | 量到幾個 | 裡面裝什麼 |
|---|---|---|---|
| u###x.fsh | models.big | 595 | 球衣本體。一個檔裡 28 張貼圖 595 個檔全部都是 28 張,而且用同一組 28 個四字代號,零例外。 剛安裝好的原版是 433 個檔,同樣 28 張、 解壓後全部剛好 732,592 個位元組 —— 見下方 |
| f###x.fsh | models.big | 646 | 背號與姓名字模。一個檔裡 36 張貼圖:zig0 到 zig9 十個數字,加二十六個字母646 個檔全部都是 36 張,零例外;其中 598 個字母代號是大寫、48 個是小寫 |
| ###.fsh | frontend\uniforms.big | 124 | 選球衣畫面的預覽圖。一個有預覽圖的球隊一個檔 量到的 768 張預覽貼圖全部都是 128×128; 一個檔裝 1 到 15 張不等,張數不一定等於那隊實際有幾套球衣 |
| ###x.fsh | frontend\uniforms.big | 568 | 佔位檔。目錄裡登記 76 到 88 個位元組,解開後只有一張 1×1 的貼圖 |
| l###.fsh | frontend\logos.big | 126 | 隊徽。126 個球隊隊徽每個都是 7 張貼圖,一隊一個 目錄裡另外還有 6 筆 l994 到 l999,不對應球隊,見下方說明 |
⭐ 2026-08-28 補:那 7 張子圖的名字固定、順序不固定。
剛安裝好的原版 132 個隊徽檔用了 36 種不同的排列
(最常見的一種佔 61 個);126 個球隊隊徽的字母集合完全一致
(都是 a d e g i j l;另外 4 個不對應球隊的
l994、l997、l998、l999 少一個 l),
而每個檔裡的隊號後綴 132/132 都一致。
跟球衣是同一條規律:照名字找子圖,不要照位置找。
| |||
### 是球隊編號(三位數,補零),x 是那一套球衣的代號字母。
預覽圖 ###.fsh 只有 000 到 123 且不跳號,
名冊最後兩格(124、125)有球衣檔但沒有預覽圖。
三個封裝檔的目錄還有幾筆不屬於上面五種:
uniforms.big 的 694 筆裡,除了 124 + 568 之外還有兩筆同樣叫 a022.fsh、
長度各 1 個位元組的項目;logos.big 的 132 筆裡,除了
l000 到 l125 之外還有 l994 到 l999 六筆,
不對應任何球隊,而且其中四筆(l994、l997、l998、l999)
只有 6 張貼圖。這幾筆是做什麼用的,本站沒有查出來。
那 568 個佔位檔真的只是佔位
568 個全部解開來看:每一個都只有一張 1×1 的貼圖,
566 個解開後是 112 個位元組,另外兩個(017d.fsh、024e.fsh)是 116 個。
再抽 000a、001a、012b、123a 四個逐位元組比對:
那 112 個位元組裡只有兩處不一樣(offset 16-19 與 100-103),存的都是 000a、123a 這種四字代號。換句話說,除了「我是哪一隊的哪一套」這個代號本身,它們不帶任何其他內容。
當年那支社群安裝程式(TiT)的說明檔裡也自己寫著:它會替你自動產生要放進
uniforms.big 的這種小佔位檔。兩邊講的是同一件事,只是一邊用說的、一邊用量的。
2026-08-28 補:剛安裝好的原版是什麼樣子
上面那些數字量的是這台裝過台灣模組的機器。 後來拿到剛安裝好、沒動過的官方英文版與官方繁體中文版,同樣的量法再跑一次 ——兩份原版逐項完全相同:
uniforms.big | 剛安裝好的原版 | 這台機器 | 差 |
|---|---|---|---|
| 目錄總筆數 | 557 | 694 | +137 |
預覽圖 ###.fsh | 124 | 124 | 一樣 |
球衣槽 ###x.fsh | 431 | 568 | +137 |
兩筆 1 個位元組的 a022.fsh | 2 | 2 | 一樣 |
多出來的 137 筆全部是球衣槽,預覽圖一張都沒多。
這跟本頁前面說的對得起來:預覽圖只有 000 到 123,
是名冊給的球隊數,不會因為多做幾套球衣而變多。
還有一件只有拿原版對照才看得出來的事 —— 槽位用的字母不一樣:
| 剛安裝好的原版 | a b c d g h i j k l m n o p | 14 個字母,沒有 e、f |
| 這台機器 | a b c d e f g h i j l m n o | 14 個字母,沒有 k、p |
兩邊都是 14 個字母,但不是同一組。 所以「字母代表第幾套球衣」這件事,在不同的名冊底下對應到的槽位並不一樣 —— 這跟本站在球員欄位反覆講的 「不要記欄號,欄號會因名冊而異」是同一件事。
佔位檔的內容在原版也確認過了:431 個裡有 422 個解開後是 112 個位元組,
另外 9 個比較長(球隊 013 的七個是 304、069 的兩個是 240)——
但那 9 個裡面一樣只有一張 1×1 的貼圖,多出來的位元組幾乎全是零。
本頁原本那句「每一個都只有一張 1×1」在原版也成立。
編號從哪裡來
球隊編號不是自己編的,它來自球隊名冊 data\database\team.dat 裡
欄位編號 6 的 team_artid(美術編號)。
那份名冊 126 列,欄位編號 0 到 54,team_artid 那一欄是 1 到 126 連號、一隊一個。
而檔名用的編號是:
team.dat 欄位 6 team_artid = 6
                             └─ 減 1 ─→ 檔名編號 005
                                         u005a.fsh · f005a.fsh · 005.fsh · l005.fsh
「差一格」這件事很容易寫錯,所以本站找了幾條互相獨立的證據:
| 怎麼驗的 | 量到什麼 |
|---|---|
| 數量對得上 | team.dat 126 列,美術編號 1 到 126;models.big 的
u###a.fsh 剛好 126 個,000 到 125 一個不缺 |
| 隊徽的規格自己分了組 | 把 logos.big 的 126 個球隊隊徽全部解開,照每張貼圖的(代號、寬、高)分群,
有 30 個用比較大的規格
(a 是 192×128、l 是 192×96、i 是 92×92),
而這 30 個正好就是 l000 到 l029,
對應美術編號 1 到 30。剩下 96 個裡,86 個共用另一組較小的尺寸, 另外 10 個(030、031、040、058、092、093、094、112、122、123)各有各的 |
| 2009 那份模組自己證明了一次 | 當年那份名冊裡,日本夢幻隊的美術編號是 123、台灣之光隊是 124;
而模組包裡日本那組檔案叫 u122a、台灣那組叫 u123a。
兩邊都剛好差一格 |
| 四種檔案共用同一套編號 | 球衣、背號字模、預覽圖、隊徽用的是同一個三位數。 改一支球隊時這四種檔要一起換,編號不能各寫各的 |
這條在速查區原本標著「推測」
為什麼你加不了新球隊那頁本來寫 「它剛好等於隊徽編號 +1,本站沒有驗過」。上面第二、第三條把「差一格」這個對應關係驗起來了。
但要說清楚還沒驗到的是哪一半: 未確認 遊戲程式是不是真的讀那一欄去抓檔案, 那要讀執行碼才知道,本站不做這件事。
那個字母 x 是什麼
字母就是「這一隊的第幾套球衣」。本站測試機這份 models.big 裡實際出現過的字母是
a 到 o,其中沒有 k。
它也不是照順序長出來的。看一個實例就懂:
編號 005 這一格(在本站測試機的名冊裡是克里夫蘭)有七套球衣:
u005a  u005b  u005d  u005e  u005f  u005n  u005o
↑ 有 d,但沒有 c所以字母是固定的欄位編號,不是流水號。 哪一個字母對應哪一套球衣,本站沒有驗出來,這頁不猜。 目前只有兩條可以寫下來的觀察:
- 各字母的數量差很多:
a有 126 個(每一隊都有)、b有 122 個,之後遞減:c86、d77、e50、f33、g11、h7、i1、j1、l5、m8、n33、o35。 - 語系檔
FEENG.LOC從字串編號 20050 起是一串連續的球衣名稱:Home、Road、Alternate Home、Alternate Road、Alternate Home 2、Alternate Road 2, 接下來是一長串帶年份的復古球衣(1986 Home、1921 Home這種)。 未確認 這串名稱跟檔名字母之間有沒有對應關係,本站沒有驗過。
每支球隊有幾套球衣,差距很大:
| 球衣套數 | 幾支球隊 | 備註 |
|---|---|---|
| 1 | 4 | 檔名編號 122 到 125,也就是名冊最後四格。
這四格寫什麼名字要看你裝的是哪一份名冊:剛安裝好的原版是
MVP Legends、MVP Heroes(見名單裡藏著 61 個名人堂球員),
本站測試機這份被模組改成 AL Future Stars、NL Future Stars;
另外兩格三份都一樣,是代號 EAA、EAB 的兩隊 |
| 2 | 31 | 只有 a、b 兩套 |
| 3 | 10 | |
| 4 | 17 | |
| 5 | 15 | |
| 6 | 15 | |
| 7 | 13 | |
| 8 | 17 | |
| 9 | 1 | |
| 10 | 3 | 最多的三隊 |
| 合計 | 126 |
自己在自己的遊戲上看一遍
上面的數字是本站測試機量的,你的遊戲一定不一樣(裝過的模組不同,球衣數就不同)。 這支腳本只讀不寫,跑一次就知道你手上那份長什麼樣。
list_uniform.py它只做一件事:把三個封裝檔的目錄讀出來,挑出屬於某一隊的項目印出來。 全程唯讀,不會碰到你的遊戲檔。需要 Python 3。
import struct, sys, os, re

def toc(path):
    f = open(path, 'rb')
    if f.read(4) != b'BIGF':
        return []
    f.seek(8)
    count = struct.unpack('>I', f.read(4))[0]
    f.seek(16)
    out = []
    for _ in range(count):
        off, size = struct.unpack('>II', f.read(8))
        name = b''
        while True:
            ch = f.read(1)
            if ch in (b'\x00', b''):
                break
            name += ch
        out.append((name.decode('latin1'), size))
    return out

game = sys.argv[1]
num = '%03d' % int(sys.argv[2])
want = re.compile(r'^[ufl]?%s[a-z]?\.fsh$' % num)
for rel in ('models.big', 'frontend/uniforms.big', 'frontend/logos.big'):
    path = os.path.join(game, 'data', *rel.split('/'))
    hit = sorted(x for x in toc(path) if want.match(x[0]))
    print('== %s  %d 個' % (rel, len(hit)))
    for name, size in hit:
print(' %-12s %10d bytes' % (name, size))球隊編號就是上一節那個「美術編號減一」。不確定的話從 0 開始試。
python list_uniform.py "你的遊戲資料夾" 5== models.big 14 個
f005a.fsh 7653 bytes
f005b.fsh 12734 bytes
f005d.fsh 7835 bytes
...
u005a.fsh 870978 bytes
u005b.fsh 787961 bytes
...
== frontend/uniforms.big 8 個
005.fsh 556715 bytes
005a.fsh 77 bytes
...
== frontend/logos.big 1 個
l005.fsh 14123 bytes- 路徑指錯了,給的資料夾底下要有一個
data子資料夾 - 那一格球隊本來就沒有球衣,換個編號再試
- 三行都是 0 個,通常是
data底下的檔案被搬過位置
一支球隊會有幾個檔
把編號 123 那一格拿來跑同一支腳本,結果是五個檔:
models.big              u123a.fsh   球衣本體
                        f123a.fsh   背號與姓名字模
frontend\uniforms.big   123.fsh     選球衣畫面的預覽圖
                        123a.fsh    佔位檔
frontend\logos.big      l123.fsh    隊徽
2009 那份模組給的是兩套(a 與 b),所以一支球隊八個檔:
u123a、u123b、f123a、f123b、
123.fsh、123a.fsh、123b.fsh、l123.fsh。
最容易漏掉的是 f### 那個檔
本站量過 595 個 u###x.fsh 的 28 個代號,
裡面沒有任何一張是數字或字母。
數字與姓名的字母是 f###x.fsh 裡那 36 張貼圖,跟球衣本體不在同一個檔裡。
這兩個檔在檔案結構上是分開的兩份資料,改一隊時建議一起換。
至於只換其中一個、遊戲畫面會變成什麼樣子,本站沒有實際跑過,不下結論。
原廠出貨的球衣規格(2026-08-28 量的)
剛安裝好的官方英文版 models.big 裡有 433 個球衣本體檔:
- 每個檔28 張貼圖,433/433 零例外
- 解壓後的大小全部剛好 732,592 個位元組,分毫不差
- 「貼圖名稱 + 像素格式 + 尺寸」的組合只有一種
- 會變的只有子圖在檔案裡排第幾 —— 8 種排列,其中一種佔 425 個
所以本頁下面那張 1X 尺寸表,在原版也成立:
jerf/jerk/jers/jert 128×128、lega–legd 128×256、
shoe 128×64 —— 全部對得上。
另外一個原本沒寫的:那 28 張一張 DXT 都沒有,
全是 16 位元,其中 5 張(hhlm、llod、msk1、
msk3、lace)用帶透明度的 4444 格式。
完整清單在模型那頁。
⭐ 順序會變這件事對寫腳本的人很重要: 要照名字找貼圖,不能照位置找。隊徽那邊也是同一個現象。
1X 與 2X 到底差在哪
模組界從以前就用「1X 球衣 / 2X 球衣」這種講法,但幾乎沒人說清楚差在哪。 這次把 2009 那份包裡兩個版本的同一個檔解開,一張貼圖一張貼圖比對,答案很乾淨: 張數一樣都是 28 張,只有其中幾張的邊長剛好變成兩倍。 這一包裡的四個球衣檔,量到有變的每一張都是寬與高同時乘二,沒有一張是別的倍數。
以中華隊那件 u123a.fsh 為例,28 張裡有 9 張放大:
| 貼圖代號 | 張數 | 1X | 2X |
|---|---|---|---|
| jerf jerk jers jert | 4 | 128×128 | 256×256 |
| lega legb legc legd | 4 | 128×256 | 256×512 |
| shoe | 1 | 128×64 | 256×128 |
| 其餘 19 個代號 | 19 | 兩版尺寸完全相同 | |
同一包裡另外三件放大的張數不一樣:u123b 除了上面九張,
還多放大了 chst、hhlm、merf、shn1
(128×128 變 256×256)與 hat、hlm1、slvl、slvr
(128×64 變 256×128),合計 17 張;日本那兩件則是各 14 張。
是一張一張決定要不要放大的,不是整包等比例縮放。
| 量的東西 | 1X | 2X | 倍數 |
|---|---|---|---|
| u123a.fsh 解開後 | 732,600 | 1,961,392 | 2.68× |
| u123b.fsh 解開後 | 887,288 | 2,705,904 | 3.05× |
| 兩隊八個檔解開後合計 | 3,618,544 | 9,713,344 | 2.68× |
| f123a.fsh 解開後 | 71,928 | 71,920 | 1.00× |
| 整包壓縮檔(英文版) | 980,095 | 1,770,512 | 1.81× |
「解開後」一律指 QFS 解壓後的實際位元組數。
背號字模完全不受 1X / 2X 影響
四個字模檔(f122a、f122b、f123a、f123b)
兩個版本解開後都是 36 張貼圖,36 張的尺寸一張都沒有變。
所以「換成 2X」動的是球衣本體,數字與字母那個檔沒有跟著放大。
1X 那組尺寸在這台機器上很少見
把本站測試機 models.big 裡 595 個球衣檔全部解開、照 28 張貼圖的尺寸分群,
總共只出現 8 種組合。其中跟模組 1X 完全一樣的只有 4 個檔:
u051b、u110b、u124a、u125a。
剩下 591 個用的都是比較大的組合。
未確認 這份 models.big
是社群重新打包過的版本,
上面這個分佈反映的是這台機器上裝過什麼,
不能拿它推論 EA 原始出貨時是什麼規格。
⚠ 「2X 就是把貼圖放大兩倍」是錯的
把這一包裡八組能對照的球衣檔全部量過之後, 這個看起來很像規則的講法站不住:
| 檔案 | 貼圖張數 | 2X 版放大了幾張 |
|---|---|---|
| f122a · f122b · f123a · f123b | 36 | 0 |
| u123a(中華隊) | 28 | 9 |
| u122a · u122b(日本隊) | 28 | 14 |
| u123b(中華隊) | 28 | 17 |
四個球衣本體檔放大的張數都不一樣(9、14、14、17 張)。
四個檔共通的只有 9 張 —— jerf、jerk、jers、jert、
lega–legd、shoe,其餘是逐檔決定的。
所以 2X 不是一條套用在全部球衣上的規則。至少在這一包裡是這樣。
⚠️ 2026-09-05 訂正:本頁原本寫「沒有任何一張貼圖是在每一個檔裡都被放大的(交集是 0)」,
那句是錯的。那個 0 是把四個背號字模檔一起算進去才得到的 ——
字模檔的 36 個代號(A___–Z___、zig0–zig9)
跟球衣本體的 28 個一個都不重疊,那個交集在結論是真是假的時候都會是 0。
只看四個球衣本體檔,交集是上面那 9 張。
這件事本站差一點寫錯。只量中華隊那一個檔,會很自然地寫成 「2X 會放大這 9 張貼圖」—— 讀起來像規則,其實那 9 張只是四個檔共通的最小集合, 別的檔還會多放大幾張。多量一個日本隊的檔才發現對不上。
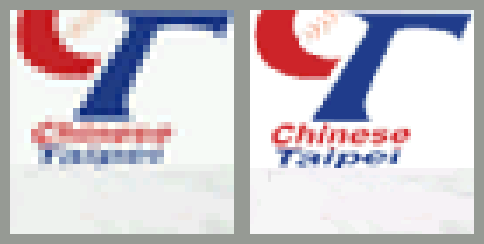
jerf 貼圖上
胸前標誌那一小塊。這是這一課唯一需要用圖說明的地方:
Chinese Taipei 那行小字在 1X 版糊成一團,在 2X 版清楚可讀。
兩邊各只取整張貼圖的 6.2%(1X 是 32×32、2X 是 64×64), 放大到同樣大小並排。沒有調整顏色,只做整數倍最近鄰放大, 所以你看到的方塊就是原本的像素。
這件球衣不是本站做的:2X 版由 tony7494550 製作, 1X 版由 小雪靈 從 2X 轉出。本站只截取說明技術差異所需的最小範圍, 不提供這些檔案的下載,也不呈現完整的貼圖,著作權歸原作者。 原作者提出即立即移除。
2009 年那句建議,跟今天量到的數字
那份模組的說明檔裡有一句第一手經驗,值得原樣留著:
因為中文語系及2X球衣檔皆較耗資源,很容易出問題及當機跳出,建議玩英文語系及1X球衣檔的MVP。那是 2009 年、在 2009 年的機器上的說法,不是現在的結論。 本站今天量到的是這兩件事:
- 2X 的檔案確實比較大:同樣兩支球隊的八個檔, 解開後從 3,618,544 變成 9,713,344 個位元組,多出 6,094,800 個。
- 中文版變大的是字型檔:中文版的
fonts.big是 1,279,340 個位元組,英文版是 420,650, 兩邊都裝 12 個.ffn。中文版裡有六個字型檔各佔 18.39 萬個位元組左右, 英文版對應的那六個是 1.0 萬到 2.8 萬。
反過來,語系檔比英文版還小
中文版的 FEENG.LOC 是 219,421 個位元組、6,436 條字串;
英文版是 415,840 個位元組、6,352 條。
中文版的位元組數只有英文版的 53%,條數反而多 84 條。
也就是說,這一包裡「中文比英文大」的部分全部集中在字型檔,語系檔本身是變小的。 未確認 當年那句「中文語系較耗資源」指的是不是這件事,本站不知道。
另外,MVP 2005 的記憶體上限是真的存在的,跟球場包一起爆掉的情形見 遊戲當掉了怎麼辦那課。
那份 2009 模組包長什麼樣
整包解開只有四個資料夾,每個資料夾就是一種組合:
| 變體 | 語系 | 球衣 | 壓縮檔大小 |
|---|---|---|---|
| Taiwan_English_1X | 英文 | 1X | 980,095 |
| Taiwan_Chinese_1X | 中文 | 1X | 1,107,418 |
| Taiwan_English_2X | 英文 | 2X | 1,770,512 |
| Taiwan_Chinese_2X | 中文 | 2X | 1,896,246 |
四個變體每個都是 20 個檔,結構完全一樣:
Uniforms1X/  或  Uniforms2X/
    Taiwan/    u123a.fsh  u123b.fsh  f123a.fsh  f123b.fsh
    Japan/     u122a.fsh  u122b.fsh  f122a.fsh  f122b.fsh
Uniforms_Menu/
    Taiwan/    123.fsh  123a.fsh  123b.fsh
    Japan/     122.fsh  122a.fsh  122b.fsh
Logos/
    Taiwan/    l123.fsh
    Japan/     l122.fsh
Chinese_LOC/  或  English_LOC/
    FEENG.LOC  IGENG.LOC
Fonts/
    fonts.big
Readme.txt
四份逐檔取雜湊比對,20 個檔分成三種行為
| 幾個檔 | 是哪些 | 四份之間 |
|---|---|---|
| 8 | 兩個隊徽 + 六個選單預覽與佔位檔 | 四份完全相同 |
| 3 | FEENG.LOC、IGENG.LOC、fonts.big |
只跟語言有關,同語言的 1X 與 2X 位元組相同 |
| 9 | 八個球衣與字模檔 + Readme.txt |
只跟 1X / 2X 有關,同版本的中文與英文位元組相同 |
所以「中文 1X」跟「英文 1X」的差別只有三個檔, 而說明檔要使用者從四包裡擇一安裝。 至於當年為什麼是四包不是兩包,說明檔沒有寫,本站不猜。
這台機器上留著一份一模一樣的檔案
遊戲資料夾旁邊有一個備份資料夾,名字寫著是中文版 1X 球衣的備份。
把裡面的 FEENG.LOC、IGENG.LOC、fonts.big
跟模組包裡的中文 1X 版取 MD5 比對,三個檔的雜湊完全相同。
兩邊的檔案日期也一樣:兩個語系檔是 2009 年 4 月,字型檔是 2008 年 5 月。
怎麼把球衣裝進去
這一節是規則。想直接動手的話有另一課
下面寫的是寫回封裝檔要遵守什麼, 不是「照著點五下就裝好了」。 ✓ 可用 要照著做的話,把一套球衣裝進遊戲那一課有腳本,會自動分類、先清點再安裝、寫完逐位元組複驗,一行還原。
想先動手改一個小東西再回來看這一節, 建議從改跑壘速度那一課開始 —— 那一課只動一個純文字檔,而且附還原腳本。
三個封裝檔,三種放法,但寫回去的規矩只有一條。
| 要放的檔 | 放進去的地方 | 備份哪個檔 |
|---|---|---|
| u###x.fsh · f###x.fsh | data\models.big | 整個 models.big(本站這台疊過模組的測試機是 535.9 MB,剛安裝好的原版只有 165.0 MB,備份很慢,但一定要) |
| ###.fsh · ###x.fsh | data\frontend\uniforms.big | uniforms.big |
| l###.fsh | data\frontend\logos.big | logos.big |
寫回封裝檔只有一條鐵律:接到檔尾
把新資料接到 .big 的最後面,然後改兩個地方:
目錄裡那一項的位置與長度(8 個位元組),以及檔頭的檔案總大小(4 個位元組)。
漏掉檔頭那 4 個位元組是最常見的壞檔原因。
而且檔頭那一欄的位元組順序不是固定的,而且它不是檔名或檔案大小的性質,
是看你手上這一份被誰重新打包過。本站以 BIGF 檔頭認過四份沒有疊模組的安裝:
剛安裝好的原版英文版 207 個封裝檔、剛安裝好的原版繁體中文版 205 個、
PK 版 205 個、打過中文更新檔的那一份 205 個,
這四份全部是 little-endian,一個 big-endian 都沒有,
連那四份裡最大的 models.big(172,992,803 個位元組)也是。
big-endian 只出現在本站測試機那份疊過模組的 data 資料夾:
384 個封裝檔裡有 10 個,落在 7 個檔名上,而這一課的主角 models.big
在測試機上正好是其中一個(它已經從 172,992,803 變成 561,891,312 個位元組)。
所以不要照檔名記,寫回去之前先讀一次,原檔用哪一種就用哪一種。
完整寫法見 BIGF 封裝格式。
另外要注意:「不要讀出全部再重新打包」這條,
理由在 uniforms.big 與 logos.big 上成立(它們有目錄沒登記的位元組),
但在 models.big 上不成立 —— 它目錄外的位元組是 0。
即使如此,接到檔尾仍然是比較安全的做法,因為你不必重算整份目錄。
這三個檔差多少,本站量過。把每一項的位置與長度攤開來看, 目錄沒有蓋到的位元組是:
| 封裝檔 | 檔案大小 | 目錄外的位元組 | 佔比 |
|---|---|---|---|
| models.big | 561,891,312 | 0 | 0% |
| uniforms.big | 37,682,083 | 9,465,878 | 25.1% |
| logos.big | 2,451,310 | 1,126,314 | 45.9% |
那些位元組是什麼,本站沒有查出來。但重新打包會把它們丟掉,所以規矩還是接到檔尾。 檔案會因此變大,這是對的,不是出錯。
- 球衣檔是 QFS 壓縮的 FSH 圖檔,
解開後開頭四碼是
SHPI(595 個檔全部如此), 像素格式見圖片的像素怎麼排。 - 一隊要換的是三個封裝檔裡的五種檔案,換之前先照上一節的清單對一遍,別漏掉某一個。
- 出問題就把備份蓋回去。三個檔各自獨立,可以一次只還原一個。
關於社群的安裝工具
當年這類模組是靠社群寫的安裝程式裝的。本站手上這份 2009 模組的說明檔指名要用
TiT 這支工具,直接選壓縮檔安裝,不必自己解壓縮。
TiT 自己的說明檔(2008 年版)寫著三件跟這課有關的事:
它是 Windows 的 .exe、它安裝時會備份被蓋掉的原檔、
它會自動產生要放進 uniforms.big 的小佔位檔。
同一份說明檔還寫著,裝副檔名為 .TiT 的檔案時,
它會連到當年的社群伺服器對一次檔案完整性,所以那種情況需要網路。
本站只提工具的名字與用途,不提供、不轉載、不放下載連結, 它的著作權歸原作者。
為什麼一定要用那支工具(2026-08-28 量的)
本站手上有一個副檔名是 .TiT 的 2010 年球衣包。看它的開頭幾個位元組:
| 檔頭 | 37 7A BC AF 27 1C | 那是 7-Zip 的識別碼 |
| 壓縮方式 | LZMA + 7zAES | 內容是加密的 |
| 檔名清單 | 不用密碼就列得出來 —— 376 個檔、4 個資料夾 | |
| 檔案內容 | 沒有密碼解不出來(376 個全部失敗) | |
所以 .TiT 就是換了副檔名的 7-Zip 檔,而且內容上了鎖。
這解釋了為什麼那份說明檔要你用它自己的安裝程式 ——
不是格式特殊,是內容加密。
順帶一個對得上的細節:那包裡列出來的
1x/u031a.fsh 是 732,592 個位元組 ——
跟剛安裝好的原版球衣分毫不差。做那包的人是照原廠規格做的。
自己做球衣,先知道這幾件事
- 拿現成的檔當模板,不要從零開始。
595 個球衣檔用的是同一組 28 個代號,零例外 —— 但排列順序有五種(244/216/94/39/2 個檔各一種,這台機器;
剛安裝好的原版是 433 個檔、8 種排列,其中一種佔 425 個 ——
兩台的種類數不一樣,正好說明順序不是規格的一部分)。所以可以照抄代號清單,不能假設順序一樣。
最省事的做法是解開一個現有的
u###a.fsh,只換掉裡面的圖,不要增減張數。 - 1X 和 2X 選一個,不要混。 兩者的張數與代號完全相同,差別只在部分貼圖的邊長。 同一支球隊兩套一大一小,資料量會差到兩三倍。
- 背號字模
f###x.fsh要跟著做。 10 個數字 + 26 個字母,共 36 張。 - 選球衣畫面的預覽圖要自己補。
###.fsh裡每一張預覽貼圖都是 128×128;###x.fsh佔位檔的內容除了內嵌代號以外都一樣。 - 隊徽是另一個檔、另一套規格。
l###.fsh裡有 7 張貼圖。2009 那份台灣隊徽用的規格 (a128×128、l128×64、g與i64×64、j64×32、d與e8×32) 跟logos.big裡最多球隊共用的那 86 個隊徽完全一致, 抄那個規格最保險。 - 只能換,不能加。 球隊數量鎖在 126,要放中職球隊就得整支蓋掉某一支既有球隊。原因見 為什麼你加不了新球隊。
這頁不能告訴你什麼
- 本站沒有真的換過一套球衣進遊戲跑給你看。 這頁量的是檔案結構與規格,「照這樣做就會成功」本站還沒有自己驗證過, 任何關於遊戲畫面會怎樣的說法這頁都不寫。 未驗證
- 哪個字母對應哪一套球衣,沒有解出來。
只知道
a是每一隊都有,b則是 122 隊有。 - 28 個代號分別對應身上哪個部位,本站沒有把貼圖畫出來對過,所以這頁不寫。 代號看起來像英文縮寫,但沒有對過就是沒有對過。
- 怎麼把改好的圖壓縮回 FSH,本站沒有做。 解開的那一半已經解決,壓回去那一半跟臉皮那頁卡在同一個地方。
- 遊戲程式怎麼決定要載哪一個檔,沒有讀執行碼。 這頁能證明的是檔名編號與名冊欄位的對應關係,不是遊戲的讀取行為。
- 沒有提供任何球衣檔或工具。本站不散布遊戲檔案,也不轉載第三方工具。
📌 重點整理
- 一句話 一套球衣不是一個檔,是散在三個封裝檔裡的五種檔案;而球衣佔
models.big的 82.6%,是這個檔裡最大的一塊,臉皮只有 14.9%。 - 五個檔家族
u###x.fsh球衣本體(一個檔 28 張貼圖)、f###x.fsh背號與姓名字模(36 張,10 個數字加 26 個字母)、###.fsh選單預覽圖(每張都是 128×128)、###x.fsh佔位檔(解開只有一張 1×1)、l###.fsh隊徽(每個都是 7 張)。 - 編號差一格 檔名編號=
team.dat欄位 6 的team_artid減 1。真正把它驗起來的是兩條:隊徽用大規格的那 30 個正好是l000到l029、2009 模組裡美術編號 123 與 124 對到u122a與u123a;另外 126 列名冊對上u###a.fsh剛好 126 個一個不缺,是數量對得上。 - 寫腳本的人最該記住這條 照名字找子圖,不要照位置找。595 個球衣檔用的是同一組 28 個代號零例外,但排列順序這台機器有 5 種、剛安裝好的原版是 8 種(其中一種佔 425 個);隊徽也一樣,原版 132 個檔用了 36 種排列,而 126 個球隊隊徽的字母集合完全一致(都是
a d e g i j l;另外 4 個不對應球隊的l994、l997、l998、l999少一個l)。種類數兩台不同,正好說明順序不是規格的一部分。 - 1X 與 2X 不是整包放大 兩版都是 28 張,只有部分貼圖寬高同時乘二。
u123a放大 9 張、日本那兩件各 14 張、u123b17 張,四個檔共通的只有 9 張(jerf jerk jers jert、lega–legd、shoe),多出來的是逐檔決定的;四個背號字模檔則一張都沒放大。八個檔解開後從 3,618,544 變成 9,713,344 個位元組。 - 最容易踩的雷是壞檔 寫回
.big只有一條鐵律,接到檔尾,然後改兩個地方,目錄裡那一項的位置與長度 8 個位元組,以及檔頭的檔案總大小 4 個位元組,漏掉檔頭是最常見的壞檔原因。而且檔頭那一欄的位元組順序不固定,也不是檔名的性質:四份沒疊過模組的安裝(原版英文版 207 個封裝檔、原版繁體中文版 205 個、PK 版 205 個、打過中文更新檔的那一份 205 個)一個 big-endian 都沒有,連原版的models.big也是 little-endian;測試機那份疊過模組的 384 個封裝檔裡才有 10 個 big-endian,這一課的主角models.big是其中之一。寫回去之前先讀一次。 - 安全網與那道牆 動手前先備份這一次真的會動到的封裝檔,最多三個、不一定是三個(球衣包裡沒有隊徽檔的話,
logos.big從頭到尾不會被碰);其中models.big最大,本站這台疊過模組的測試機是 535.9 MB、剛安裝好的原版只有 165.0 MB,備份很慢但一定要;三個檔各自獨立,可以一次只還原一個。另外球隊數量鎖在 126,只能換不能加,要放中職球隊就得整支蓋掉某一支既有球隊。 - 本站沒驗的 本站沒有真的換一套球衣進遊戲跑給你看,這頁量的是檔案結構與規格,任何關於遊戲畫面會怎樣的說法都不寫;哪個字母對應哪一套球衣沒解出來;28 個代號對應身上哪個部位沒把貼圖畫出來對過;怎麼把改好的圖壓縮回 FSH 沒有做;遊戲程式怎麼決定要載哪一個檔沒有讀執行碼。
接下來
- BIGF 封裝格式:動任何
.big之前必看的那條鐵律 - 模型與臉皮 models.big:球衣就住在這個檔裡,另外 14.9% 是臉
- 為什麼你加不了新球隊:球隊編號 126 這道牆在哪一層
- 幫球員換一張臉:同一個檔,但那課完全不用動它
- 當年那兩份說明書,一句一句拿今天的檔案對過:同一份 2009 模組的另一半故事